
9月14日消息(报道:王佩)2026年9月,具身智能数据赛道同时发生了两件意味深长的事。
一边是服贸会上,北京石景山人形机器人数据训练中心完成2.0升级,新建多视点光场采集系统,构建“采集—建模—训练—验证—回流”的完整数据闭环,以“石景山具身智能训练中心”的全新身份亮相。另一边,京东在全球科技探索者大会上宣布,两年内采集超1000万小时人类真实场景视频数据,五年内采购300万台机器人,并发布实时可交互世界模型JoyAI-Echo WM,一口气提出六个“全球最大”的目标。
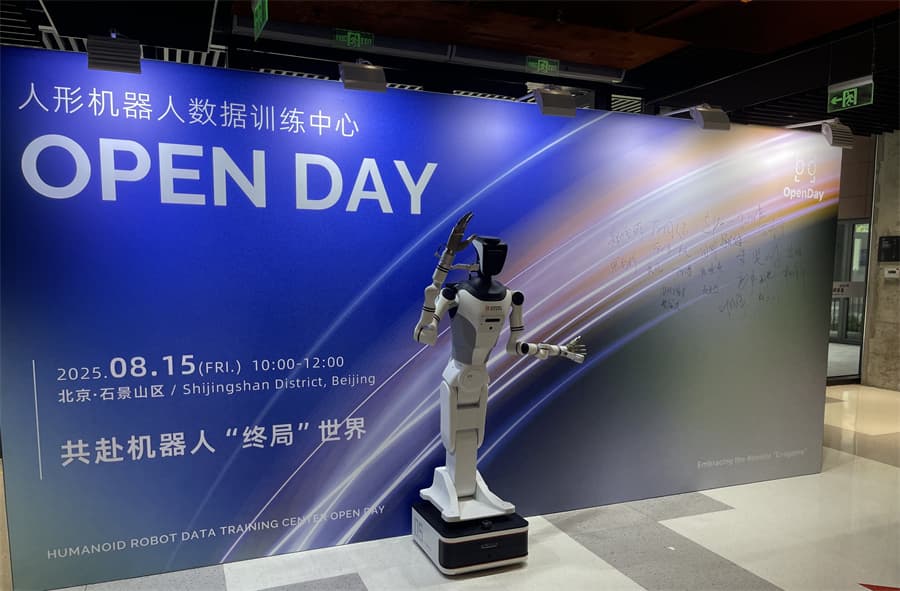
图:机器人茶馆拍摄
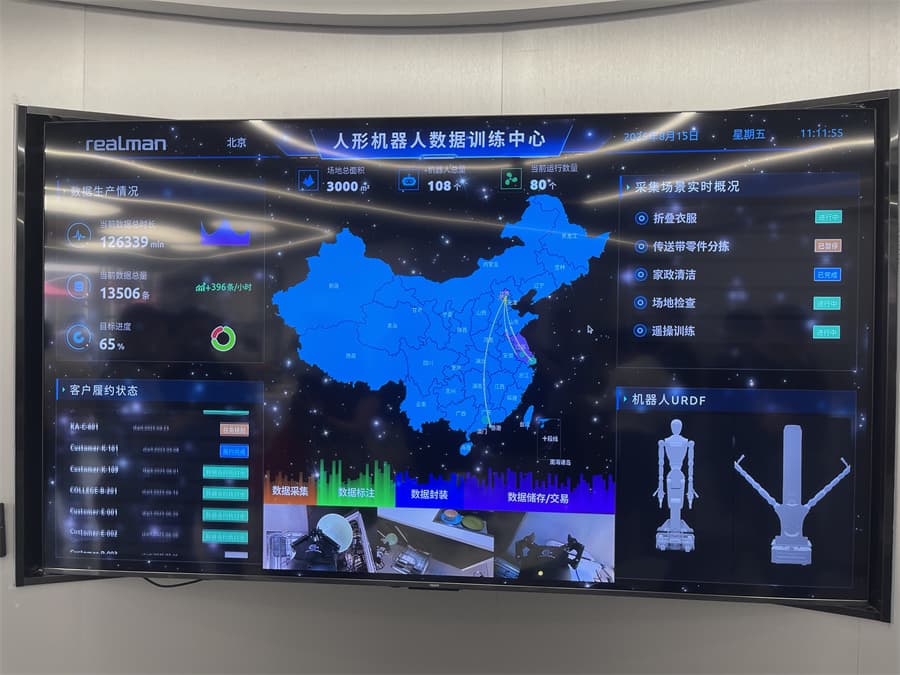
而就在数周前,北京人形机器人数据训练中心首个被曝停止运营。这个2025年3月在石景山首钢园揭牌的设施,曾部署108台机器人、搭建十大实景场景,设计年数据交易量超100万条,是国内首个集数据采集、场景训练与产业协同于一体的机器人训练设施。
一边关停,一边升级,一边大举扩张。那么,给机器人“喂饭”,到底是一门怎样的生意?
算一笔集中式数采工厂的经济账
机器人茶馆和机器人行业的圈内朋友交流,他们告诉茶馆君,要理解这门生意,先要理解它的成本结构。
集中式数采工厂的核心假设是:把机器人本体、复刻场景、遥操人员集中在同一物理空间,通过规模化摊薄单位数据成本。但这个假设在当前阶段并未成立。
资产端,单台人形机器人造价约60万至70万元,百台级中心仅本体投入即达数亿元;加上场地、实景搭建、遥操工位与运维团队,构成持续性的刚性支出。产出端,遥操员8小时工作日中,有效采集时长仅2至5小时,部分场景甚至只有1小时左右,其余时间消耗在设备调试、场景复位和故障处理上。每完成一次任务,物体需要重新摆回原位。
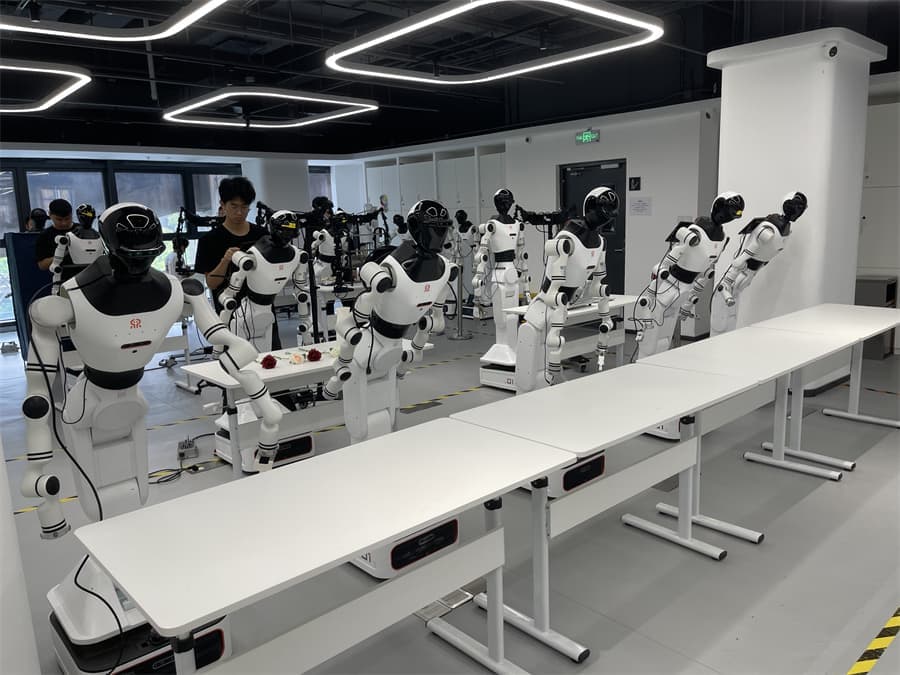
据知情人士测算,单台机器人单小时有效数据成本可达500元以上,计入场地与设备折旧后,综合成本达数百至上千元。而具身智能数据的市场定价在200至500元/小时,真机数据可达500至1000元/小时。换言之,集中式数采中心在成本与售价之间存在结构性倒挂。
更要命的是营收结构:这类项目的产出物只有训练数据,不承接真实业务,缺乏经营性现金流对冲固定开支。一旦外部融资节奏放缓,项目即进入现金流压力区间。已有数采工厂因回本周期超出预期,将部分机器人转售给院校。
机器人茶馆注意到,中国信通院的报告也印证了知情人士的这一判断:训练场属于重资产投入,仅依靠数据出售难以覆盖前期成本,回本周期较长。
而上文提到的,北京首个人形机器人数据训练中心关停方“睿尔曼智能”,其创始人郑随兵在朋友圈确认了这一消息。公司方面的解释是:北京中心采用集中式部署,完成的是“实验室场景”数据采集的验证;而具身智能要真正“真干活”,数据必须来自真实场景。公司已将重心转移至常州具身智能数据实验平台,部署150台RealBOT机器人、覆盖超1000种真实作业任务。
在机器人茶馆看来,这不是个案,而是一种模式的分化信号。
数据分布偏移:片场模式的结构性缺陷
成本问题尚可通过运营优化缓解,但数据分布问题则是集中式模式的深层矛盾。
集中式数采工厂在室内1:1复刻家庭、商超、装配工位等场景,环境变量被人为收敛:光照恒定、物体位姿固定、任务流程预编排。这种低方差环境中产出的数据,与高方差的真实世界之间存在显著的分布偏移。据公开研究,机器人在仿真环境中的任务成功率约89.4%,进入真实家庭环境后骤降至12.4%。
这意味着,即便数采中心能以较低成本产出海量数据,这些数据在真实场景中的泛化能力仍然存疑。清华大学丁贵广团队的研究指出,超过90%的采集数据在未经精细化处理前,难以直接用于模型训练,存在重复动作、失败无标注、传感器噪声、缺乏物理反馈等问题。
真正的壁垒不是采集规模,而是高价值数据的精炼能力。
京东的“以场景养数据”路径
京东选择的是一条截然不同的路线。
其核心逻辑是:数据采集不建独立的数采工厂,而是嵌入京东已有的供应链场景中。截至2025年末,京东物流在全国运营超过1600个仓库,拥有数千台仓储机器人和上千台无人配送车,供应链覆盖1.9万余个配送站及网点、超1000万企业客户。这些场景本身就是数据来源——机器人“在干活中采集数据”,采集成本由物流业务本身承担。
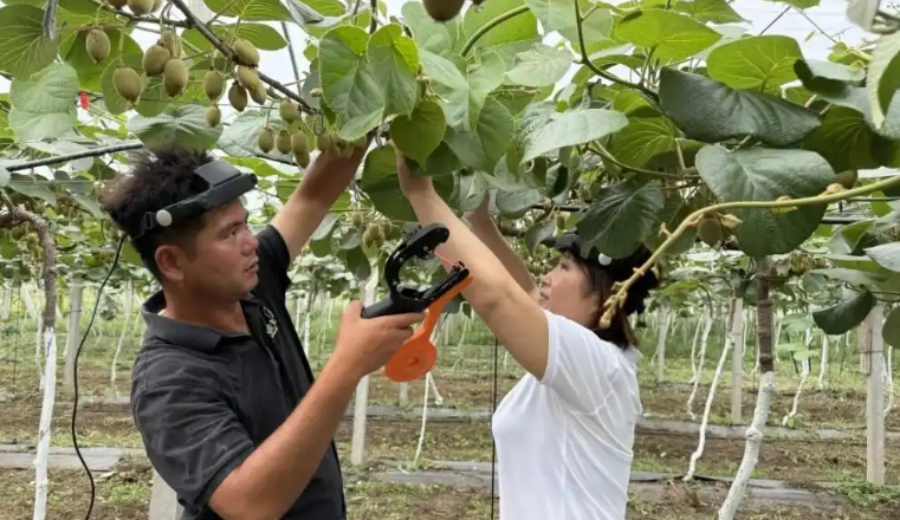
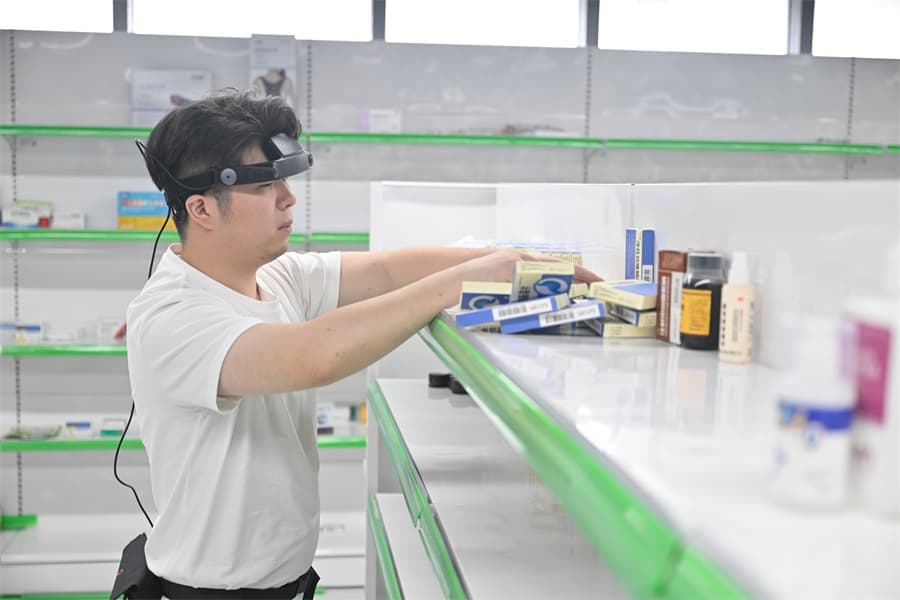
京东还探索了另一条更具争议的路径:通过家政阿姨佩戴头戴设备采集家庭场景视频。用户付费请阿姨做家政,数据被京东用于训练模型。这种模式与Figure AI的付费采集模式相反,在《个人信息保护法》收紧的背景下,面临合规风险。
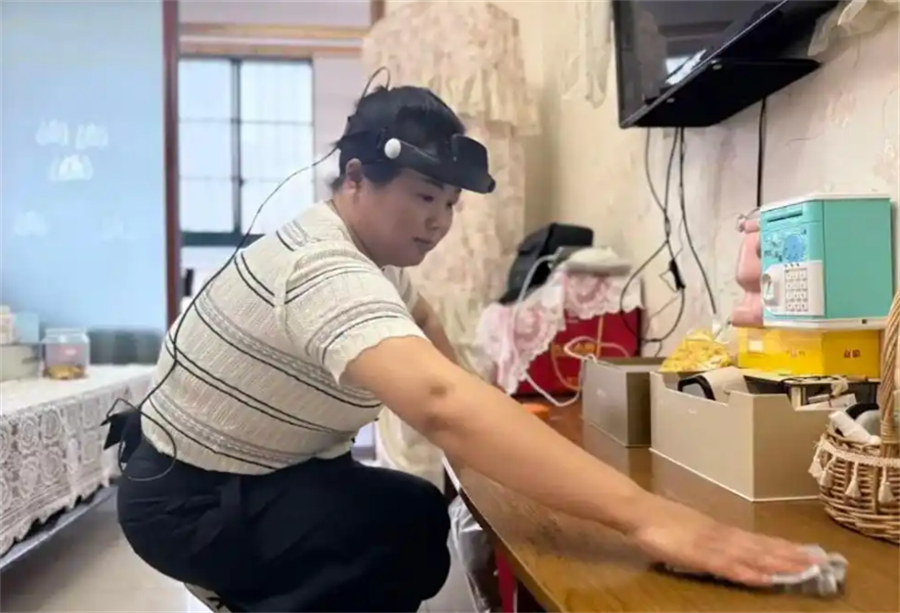
“以场景养数据”的逻辑在工程经济学上是成立的,采集成本由主营业务承担,不需要独立的营收闭环。但这套模式也有明显的边界:京东物流场景的数据主要覆盖仓储、分拣、配送等物流环节,对于家庭服务、工业精密操作等场景的覆盖能力有限。而京东自身的数据大概率封闭自用,不会开放给其他厂商。这意味着数据基建不是统一市场,而是诸侯割据。
从“采数据”到“卖铲子”:产业链的分层
在集中式数采与场景嵌入式采集之外,产业链正在分化出更细的层次。
最底层是采集层,包括居家采集员(时薪约17元)、场地采集员(时薪22至31元)、真机遥操作员(时薪75元以上)和无本体采集员。第二层是平台层,连接供需、组织采集,外包平台从数据公司接单后分包给采集员,中间抽取30%至50%的差价。第三层是数据层,将原始数据清洗、标注、对齐、仿真增强,打包成可训练的数据产品,代表企业如光轮智能、智域基石等。第四层是应用层,包括人形机器人本体公司、世界模型团队和产业应用方。
在这个金字塔结构中,真正的价值捕获正在从“采数据”向“卖铲子”迁移。
五一视界发布的具身智能数据底座AperData,软硬一体采集套装定价5100元,显著低于市场现有专业动捕设备的十万元以上价格。其战略意图不在于硬件利润,而在于通过降低中游数据服务商的准入门槛,快速铺设采集网络节点,进而以数据格式标准、双边网络效应和全链路协同构建长期壁垒。数据公司承担地面运营与人力组织,五一聚焦工具研发与标准制定,避免重运营投入,通过设备销售与云服务实现规模化复制。
光轮智能则选择了另一条路径:聚焦仿真合成数据与物理AI,提供涵盖数据采集、策略训练、仿真评测到Sim2Real部署的全流程解决方案,半年融资20亿元,估值突破百亿,成为全球首个具身数据独角兽。
还有公司走得“更远”,宣称从互联网单目RGB视频中提取多模态机器人训练数据,综合采集成本降到行业平均水平的千分之五。如果这类技术路径成熟,数据供给的底层逻辑将被彻底改写。
这门生意的判断
回到“喂饭”这个比喻。给机器人喂饭,本质上是在为具身智能的“大模型时刻”储备燃料。但燃料的价值不取决于数量,而取决于纯度。
全球具身智能数据市场2025年规模约2.42亿美元,同比增长181.4%;预计2030年攀升至52.5亿美元,复合年增长率达85%。中国市场规模达5亿元人民币,同比增长203%,占全球约四成。赛道很热,但热钱涌入的方向正在发生变化。
中信证券的研究判断是:数据语料公司的商业化变现步伐明显快于具身模型企业,值得重点关注在数据要素、模型训练及本体构型环节具备横向贯通潜力的标的。
而智源研究院院长王仲远提醒:具身智能面临高质量数据极度匮乏与商业化伪需求泡沫的双重风险。当下的具身大模型依然面临“不好用、不通用、不易用”的核心痛点,若机器人无法在真实场景中满足用户预期,热度过后行业可能面临冷却期。
集中式数采工厂的退场,场景嵌入式采集的兴起,工具型平台的卡位,这些变化指向同一个判断:数据基建的竞争正在从“谁采得多”转向“谁的数据更有用”。堆量不是壁垒,精炼才是。谁先建立高价值数据的精炼能力、定义数据格式与接口标准,谁就能掌控生态,让对手的追赶成本高到无法竞争。
在机器人茶馆看来,“喂饭”正在变成一门大生意,但这门生意的赢家,大概率不是那些喂得最多的人,而是那些知道该喂什么、怎么喂、喂完之后机器人真的能学会的人。
来源:速途网