7月15日,通用具身基础模型公司智在无界BeingBeyond正式发布Being-M0.7——全球首个全身移动操作隐式世界动作模型(Latent WAM)。
这不是一个只能让机器人”看到”世界的模型,而是一个能让机器人”理解”世界如何运转、并据此做出全身移动操作的模型。它打通了从视觉感知到全身移动、再到灵巧操作的完整链路,让机器人不再局限于桌面及操作任务,而是成为真正具备人类全身协调能力的智能体。
Being-M0.7通过超 10000 小时的人类第一人称视频预训练和极小样本真机适配,在”隐空间”(latent space)中,基于隐式视觉信息和运动信息推演物理变化,让机器人在真正理解物理世界的基础上,通过全身移动操作与物理世界交互。
在被具体化为机器人可执行的指令之前,模型先从大规模以人为中心的数据中学习了三项核心能力:视觉上下文理解、未来状态预测、以及人形运动学结构的隐式表征。换言之,模型在“学会控制”之前,已经先“学会了理解”。
论文链接:https://research.beingbeyond.com/being-m07/being-m07.pdf
- 从Being-H到Being-M,智在无界持续引领隐式世界动作模型范式
智在无界是全球率先押注大规模人类视频训练路线的具身智能企业,也是全球极少数同时布局通用灵巧操作与移动操作模型的创新公司,更是国内首个推出原生隐空间世界动作模型的团队。
今年4月,智在无界发布了Being-H0.7,将数据规模扩展至 20 万小时人类第一人称视频。在 6 项国际性权威评测中,H0.7 综合排名全球第一,同时也是首个覆盖跨本体、跨场景、连续动态、流体、柔性物体、物理规律与上下文推理等七大关键维度的通用具身世界模型。
Being-M0.7是这一隐式世界动作模型路线的最新成果,也是全球首个将隐式世界动作模型能力从”桌面灵巧操作”扩展到”全身移动操作”的模型。隐式世界动作模型让机器人建立对物理世界的”内心推演”:不只是识别眼前的物体,还要预判它们会如何运动、如何相互作用、自己的动作会对环境产生什么后果。这些推演不需要生成任何像素画面。模型在表征里直接”感知”到物理规律的存在,从而精准输出动作完成任务。

二、基于MoT架构,Vision和Motion分工协作,实现高效数据利用
人形机器人的全身移动操作,不仅需要第一人称视觉信息(Vision)来进行空间感知,还需要理解自身在物理世界的位置、姿态,更需要结合空间感知进行决策和规划,输出未来要执行的运动信息(Motion)。
但高质量的Motion数据一般通过动捕获得,成本较高;Vision与Motion对齐的配对数据更为稀缺。在这种情况下,如何充分利用所有可用数据,是实现人形机器人领域具身基础模型规模化的关键。
智在无界选择了 MoT(Mixture-of-Transformers)这一混合 Transformer 多模态模型架构。它的核心设计是:让视觉和运动各自有专门的”处理通道”,只在需要时交换信息。
它不仅可以处理Vision+Motion配对数据,还可以同时处理纯Vision数据、纯Motion数据,将这些数据高效融合利用。这不仅扩大了可用数据规模,更容易规模化训练,也可以从概率建模角度理解为对联合分布的边际约束。Vision+Motion的配对数据充分发挥跨模态注意力的优势,非配对数据则各自贡献于对应的模态流,天然兼容模态不完备的真实世界数据。
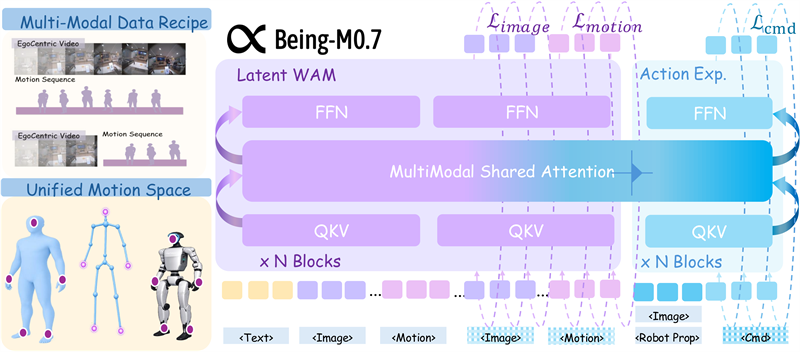
与此同时,为了解决人类与机器人在本体形态上的根本差异,智在无界进一步引入了一套统一的运动表征,将人类运动与人形机器人轨迹纳入同一表示空间。相比于仅使用可执行指令标签进行监督的传统方案,这套共享表征提供了更丰富的后训练监督信号——模型可以从人类数据中提取稠密的运动级知识,而非仅依赖稀疏的任务标签。
另外,统一的运动表征在推理阶段建立了额外的运动级反馈通路,为实现协调的全身控制提供了闭环支撑。
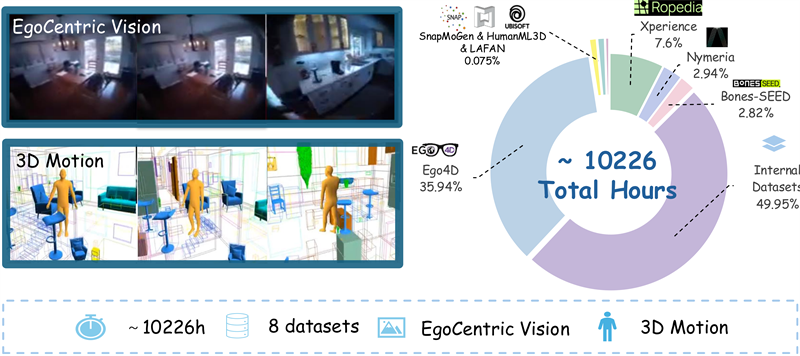
Being-M0.7 的预训练基于超过 10000 小时的人类第一人称视频数据及motion数据。在掌握了全身运动空间中的协调模式后,真机数据只需将隐式世界模型映射到具体机器人的本体运动学,即可完成基于视觉的移动操作策略训练。因此,后训练只需要较少样本完成真机适配。
三、可扩展的多模态融合范式,通往更通用的具身智能
在智在无界看来,Vision-Motion MoT 架构还有一个更为深远的意义:它确立了一套可扩展的融合范式,为具身基础模型打开了新的可能性。
在Being-M0.7的训练中,智在无界团队建立起超 10000 小时的大规模混合模态预训练数据,从过去昂贵、稀缺的机器人真机演示,拓展至海量人类行为数据。而Being-M0.7作为面向人形机器人的隐式世界动作模型,也首次实现了第一人称视觉Vision和Motion两个模态的联合预训练。
这只是起点。未来,随着文本、音频、触觉等多模态数据的持续引入,模型对物理世界的理解将更加立体和完整。文本可以提供高层任务语义,音频可以捕捉环境声音线索,触觉可以反馈接触力与材质信息——这些信号与视觉、运动数据在 MoT 架构中分层融合,将让机器人不仅能”看到”和”动起来”,还能”听懂指令”、”感知材质”、”理解语境”。随着数据规模的持续Scale Up,这套范式的能力边界将持续向外拓展。
这正是具身基础模型的发展趋势:在预训练中覆盖更多模态、更多维度的数据,让模型从单一感知通道走向全感官融合。
接下来,智在无界将围绕 Being-M 系列模型持续迭代,不断探索隐式世界动作模型的上限,走向真正通用的具身智能。
– End –
关于智在无界BeingBeyond:
智在无界BeingBeyond专注于具身通用基础模型的研发与应用,是国内率先提出以大规模人类视频数据训练通用模型框架的企业,也是国内首个推出原生隐式空间世界模型的AI初创公司。以“推动人形机器人从实验室走向日常生活”为使命,智在无界致力于解决具身智能的底层核心技术难题,引领人形机器人技术革命。
智在无界成立于2025年5月,已完成「大规模人类视频训练」的多个重要里程碑:相继发布全球首个基于一千小时、一万小时、二十万小时人类视频预训练的具身模型 Being-H0、H0.5和H0.7。在多项国际性权威评测中,Being-H0.7综合排名全球第一,同时也是首个覆盖跨本体、跨场景、连续动态、流体、柔性物体、物理规律与上下文推理等七大关键维度的通用世界模型。
智在无界创始人卢宗青是北京大学计算机学院长聘副教授,国家级青年人才,智源学者,长期担任 ICML、NeurIPS、ICLR等顶级会议(高级)领域主席。公司核心团队来自全球顶尖高校,深耕强化学习、多模态大模型以及大规模预训练等具身智能前沿领域。
来源:速途网
相关推荐
-
发现中国版Atlas:世界模型的50亿美元想象,正在中国落地
9 月 1 日,李飞飞创办的 World Labs 发布新一代世界模型 Atlas。沿着它给出的技术路线回看中国,一个此前并未被资本市场充分定价的样本浮出水面:影身智能。 从技术路线、模型能力到产品形态综合来看,影身智能是国内现阶段最接近Atlas的创业公司。两家公司都在推动 AI 从二维画面走向动态世界:理解空间结构...
-
商汤X业务再出“百亿企业”:商汤医疗B轮融资上亿美元,有望冲刺“医疗世界模型第一股”
7月28日消息,据知情人士透露,商汤医疗近日完成超1亿美元B轮融资,投后估值突破百亿元人民币,成为国内首个估值破百亿的医疗世界模型公司。随着本轮融资落地,商汤医疗已进入Pre-IPO关键阶段,并正在筹备上市前最后一轮融资。 本轮B轮融资的投资方阵容涵盖产业资本、金融机构与跨境资本。 产业资本方面,联创资本、中国电...
-
从精神到肉体,AI走向真实环境需要世界模型
生活在数据中心里的人工智能,在很多人心目中似乎已经变成了无所不知的存在,可一旦给他们装上躯体,哪怕是汽车的轮子,却难以做到无所不能,甚至路都走不稳。有趣的是,即便是刚出生的婴儿,他们喜欢进行的第一个尝试,便是不断把玩具、餐具等任何物品,从高处扔向地面,从中了解到这个万有引力的物理世界,但这却是大语言模型仅仅可以讲述,却并不真正懂得的简单物理常识。
-
生成预测四大权威榜单第一!开悟世界模型确立具身智能世界模型新标杆
近日,大晓机器人开悟世界模型(Kairos)同时在 RoboTwin 2.0、LIBERO-Plus、WorldModelBench Robot、DreamGen等全球针对世界模型视频生成和状态预测的权威具身智能评测中均实现第一,超越 Cosmos3、PI、MotuBrain、being-H0.7、Abot、Fast-...
-
大晓机器人发布全球首个全屋三维可交互世界模型
6月5日,大晓机器人联合香港中文大学多媒体实验室、深圳河套学院发布最新世界模型研究成果 Kairos-HomeWorld,这是全球首个实现全屋生成、个体物体全交互的世界模型统一框架。该技术突破了现有室内场景生成仅能覆盖单房间、缺乏全局一致性与可操作性的行业瓶颈,能够一键生成结构连贯、物理合理、功能完整的全屋三维场景,为...
-
Google I/O 2026炸场:世界模型、AI数字水印来了!Gemini正式进入“Agent时代”
北京时间5月20日凌晨,谷歌年度开发者大会Google I/O 2026在加州山景城拉开帷幕,谷歌 CEO 桑达尔・皮查伊正式宣布:我们已经进入了"智能体Gemini时代"。 十年 AI-first,从实验室走向数十亿人 "十年前我们将公司转向AI-first,今天我们仍然认为AI是推进我们使命、大...
-
大晓机器人开源实时生成世界模型 Kairos 3.0-4B
近日,大晓机器人重磅开源开悟世界模型 3.0(Kairos 3.0)-4B 系列具身原生世界模型。作为业内首个实现“多模态理解 — 生成 — 预测”一体化的开源具身原生世界模型,该模型以“物理因果一致、跨本体泛化、超长时交互、云侧实时生成、轻量化高效能、端侧本体控制”为核心优势,性能全面领跑国内外主流具身世界模型。 K...
-
大晓机器人完成天使轮融资
大晓机器人已于近期完成天使轮融资。本轮融资由蚂蚁集团领投,启明创投、金景资本、弘毅投资、联想创投、上海交大母基金菡源资产等机构跟投,老股东商汤国香资本持续增资。 本轮募资金额将用于大晓机器人推进“以人为中心”的ACE具身全栈研发范式的技术迭代,加速环境式数据采集、开悟世界模型3.0(Kairos 3.0)的研发,推动具...
-
阿里云推出全新AI加速框架,可用于构建自动驾驶和世界模型
6月23日消息(报道:李楠)今日,阿里云推出面向自动驾驶领域模型的训练、推理加速框架PAI-TurboX,该框架可提升感知、规划控制乃至世界模型的训推效率,在多个行业模型的训练任务中,PAI-TurboX均可缩短50%的时间。 目前,业界主流的自动驾驶方案需要融合图像、激光雷达、毫米波雷达、GPS等多个模态数据,...